Большинство современных инструментов ИИ работают на основе облачных вычислений, а это значит, что им требуется постоянное подключение к интернету. Хотя существуют возможности запускать инструменты ИИ локально на наших устройствах, распространено мнение, что для этого требуется мощное и дорогостоящее оборудование.
Я тоже так думал, пока не решил протестировать некоторые встроенные инструменты ИИ на относительно старой машине — видеокарте GTX 1070, которой уже почти десять лет, — и не обнаружил, что это действительно возможно и эффективно. Этот эксперимент открыл новые возможности использования ИИ даже на устройствах со скромными характеристиками, сделав эту технологию доступной более широкому кругу пользователей.

Быстрые ссылки
Зачем вам нужен локальный чат-бот на базе искусственного интеллекта?
Я использовал бесчисленное множество онлайн-чат-ботов на базе искусственного интеллекта, таких как ChatGPT, Gemini, Claude и другие. Они отлично работают. Но что делать, если у вас нет подключения к интернету, а вы всё равно хотите использовать чат-бота с искусственным интеллектом? Или если вам нужно поработать над чем-то очень личным или информацией, которую нельзя разглашать ни по работе, ни в других целях?
В этом случае вам нужна локальная автономная большая языковая модель (LLM), которая сохранит все ваши разговоры и данные на вашем устройстве. Локальный чат-бот ИИ Использование возможностей искусственного интеллекта без подключения к Интернету.
Конфиденциальность считается Одна из основных причин использования крупной локальной языковой модели —Но есть и другие причины, такие как избежание цензуры, использование в автономном режиме, экономия средств, возможность настройки и т. д. Это предоставляет вам Локальный чат-бот с искусственным интеллектом Полный контроль над вашими данными, гарантия того, что ваша конфиденциальная информация останется в безопасности и сохранности.
Что такое квантованные большие языковые модели (квантованные LLM)?
Аппаратное обеспечение — самая большая проблема для большинства людей, использующих большие языковые модели (LLM) локально. Для работы самых мощных моделей ИИ требуется мощное оборудование. Помимо простоты использования, аппаратные ограничения — ещё одна причина, по которой большинство чат-ботов на базе ИИ основаны на облачных вычислениях.
Аппаратные ограничения — одна из причин, по которой я думал, что не смогу запустить большую языковую модель (LLM) нативно. Сейчас у меня довольно скромный компьютер с процессором AMD Ryzen 5800x (выпущен в 2020 году), 32 ГБ оперативной памяти DDR4 и видеокартой GTX 1070 (выпущена в 2016 году). Конечно, это не топовое железо, но, учитывая, как мало я сейчас играю в игры (а когда играю, то выбираю… Старые, менее ресурсоемкие инди-игры) и высокой стоимости современных графических процессоров, я доволен тем, что имею.
Однако оказывается, что вам не нужна самая мощная модель ИИ. Квантованные большие языковые модели (квантованные LLM) Это модели ИИ, которые стали меньше и быстрее за счет упрощения используемых ими данных, в частности чисел с десятичной точкой.
ИИ обычно оперирует числами высокой точности (например, 32-битными десятичными), что потребляет значительный объём памяти и вычислительной мощности. Квантование преобразует эти числа в числа меньшей точности (например, 8-битные целые), не влияя существенно на поведение модели. Это означает, что модель работает быстрее, использует меньше места на диске и может работать на устройствах меньшего размера (например, смартфонах или периферийном оборудовании), хотя иногда и с небольшой потерей точности.



Это означает, что хотя мое старое оборудование, безусловно, с трудом справилось бы с запуском большой языковой модели (LLM), такой мощной, как Llama 3.1 с 205 миллиардами параметров, вместо этого оно могло бы запустить меньшую квантовую модель 8B.
И когда Использование OpenAI Для моих первых полностью квантованных моделей вывода с открытыми весами я подумал, что пришло время проверить, насколько хорошо они работают на моем старом оборудовании.
Как использовать большую языковую модель (LLM) локально с видеокартой Nvidia GTX 1070 и LM Studio?
Хочу начать этот раздел с того, что я не являюсь экспертом ни в локальных больших языковых моделях (LLM), ни в программном обеспечении, которое я использовал для запуска этой интеллектуальной модели на своём компьютере. Здесь я просто представлю описание того, как я запустил умного чат-бота локально на моей видеокарте GTX 1070, а также оценку эффективности этого решения. Цель — продемонстрировать, как можно использовать имеющиеся вычислительные мощности для запуска сложных моделей ИИ без необходимости использования облачных сервисов.
Скачать LM Studio
Для локального запуска большой языковой модели (LLM) требуется специализированное программное обеспечение. В частности, программа ЛМ Студия, бесплатный инструмент, позволяющий загружать и запускать модели LLM локально на вашем устройстве. Перейдите на главную страницу LM Studio и выберите Загрузить для [операционная система] (Я использую Windows 10.) LM Studio — идеальная платформа для разработчиков и исследователей, которые хотят экспериментировать с различными большими языковыми моделями и оценивать их производительность на своих персональных машинах перед развертыванием.
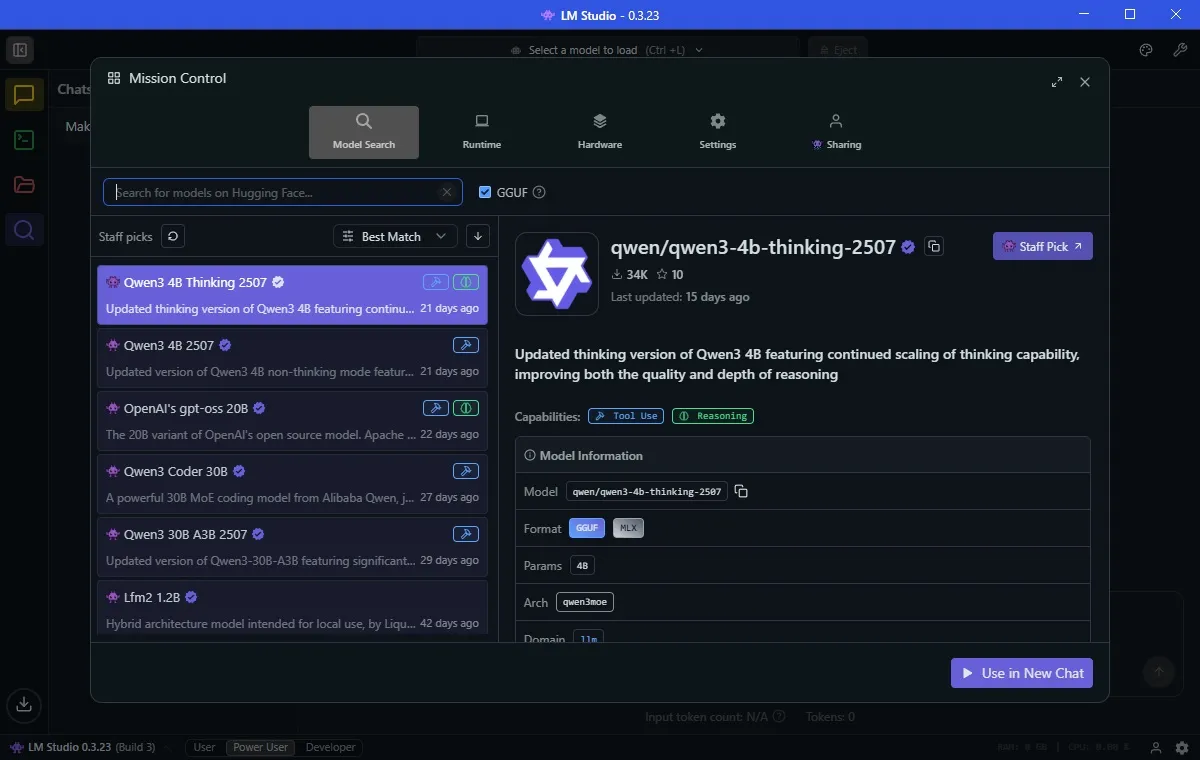
Это стандартный процесс установки Windows. Запустите программу установки, завершите установку, а затем запустите LM Studio. Рекомендую выбрать Power User Потому что он открывает некоторые полезные возможности, которые вам, возможно, будет интересно изучить. Эта опция обеспечивает более точный контроль над настройками программы и расширенные возможности для персонализации использования моделей LLM. С LM Studio вы можете легко и эффективно исследовать мир больших языковых моделей.
Загрузите свою первую локальную модель ИИ
После установки вы можете загрузить свою первую большую языковую модель (LLM). Выберите вкладку Откройте для себя (Значок увеличительного стекла). LM Studio легко отображает собственные модели ИИ, которые лучше всего подойдут для вашего устройства.
В моем случае предлагается загрузить шаблон под названием Qwen 3-4b-thinking-2507Название модели — Qwen (Разработано китайским технологическим гигантом Alibaba), что является третьей версией этой модели. Значение «4b» означает, что эта модель использует четыре миллиарда параметров для ответа, а «thinking» означает, что модель потратит время на обдумывание ответа, прежде чем ответить. Наконец, последнее обновление модели было 2507, 25 июля.
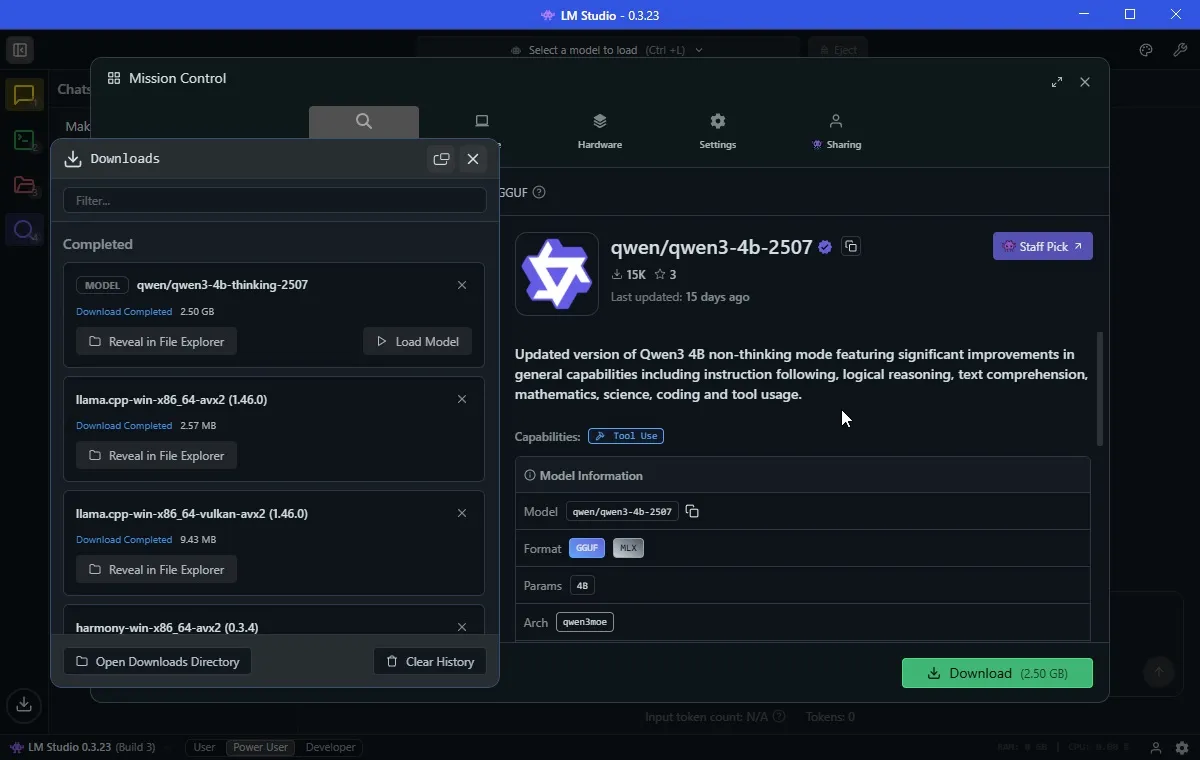
Размер Qwen3-4b-thinking составляет всего 2.5 ГБ, так что загрузка не займёт много времени. Ранее я также скачал OpenAI/gpt-oss-20b, который весит 12.11 ГБ. Он также содержит 20 миллиардов параметров, поэтому должен давать более «лучшие» ответы, хотя и потребует больше ресурсов.
Теперь, кроме Сложности именования моделей ИИПосле загрузки LLM вы почти готовы начать его использовать.
Перед запуском модели ИИ перейдите на вкладку Аппаратные средства Убедитесь, что LM Studio правильно распознаёт вашу систему. Вы также можете прокрутить вниз и настроить защитное ограждение Вот. Я настроил брандмауэры на своём компьютере так, чтобы Уравновешенный, предотвращая потребление слишком большого количества ресурсов какой-либо одной моделью ИИ, что может привести к перегрузке системы.
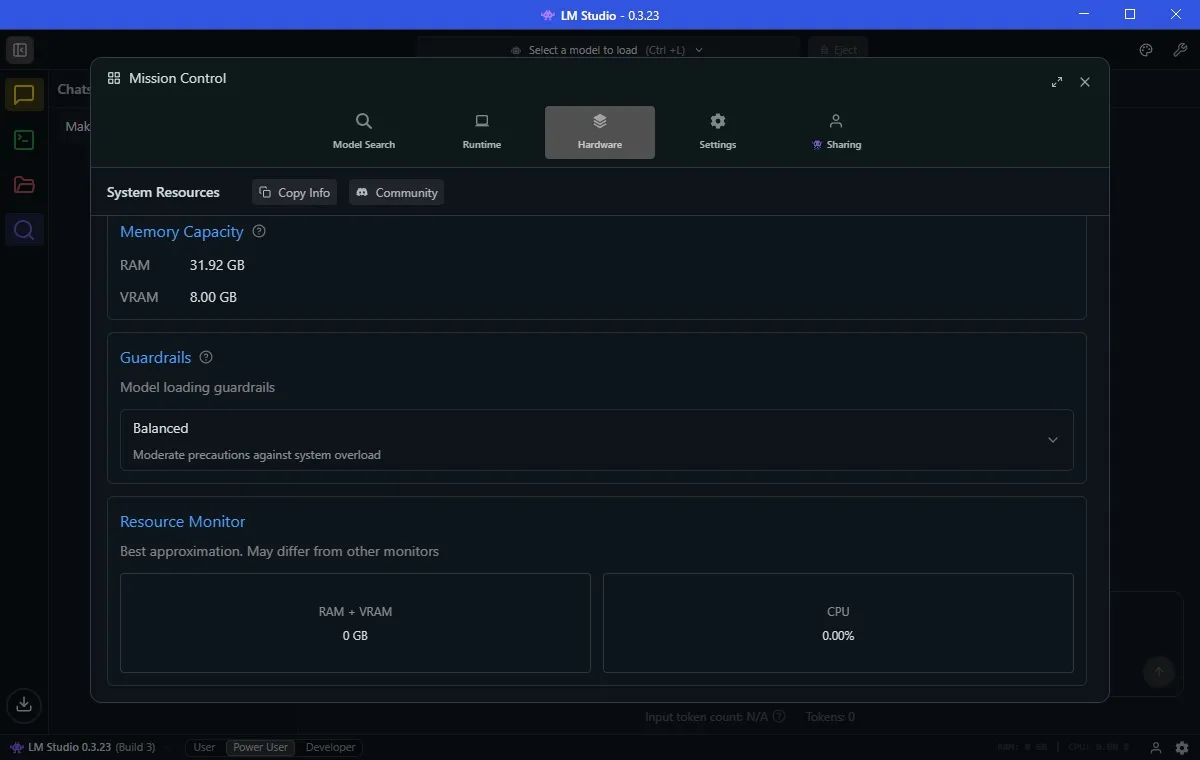
Вы также заметите Монитор ресурсов Ниже Guardrails. Это простой способ узнать, сколько ресурсов потребляет ваша модель ИИ. Стоит отслеживать производительность, если вы, как и я, используете довольно ограниченное оборудование, чтобы избежать неожиданного сбоя системы.
Загрузите свою модель ИИ и начните ее использовать.
Теперь вы готовы начать использовать своего ИИ-чат-бота локально на вашем устройстве. В LM Studio выберите верхнюю панель, которая служит инструментом поиска. Выбор имени ИИ загрузит модель ИИ в память вашего компьютера, и вы сможете начать вводить команды и вопросы. Этот процесс необходим для активации возможностей большой языковой модели (LLM) непосредственно на вашем устройстве, что позволит вам быстро и интерактивно работать с ИИ без необходимости постоянного подключения к Интернету. Помните, что производительность модели зависит от характеристик вашего устройства, поэтому убедитесь, что у вас достаточно ресурсов для эффективной работы вашей ИИ-модели.
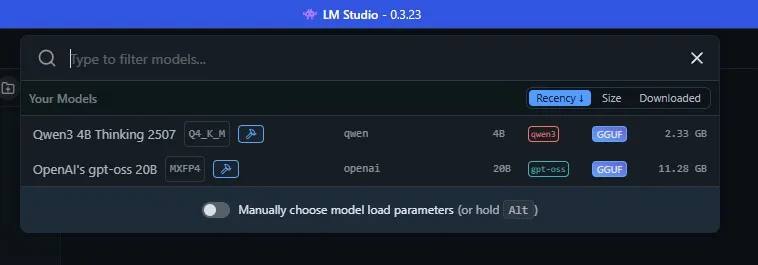
Запуск модели ИИ локально на старом оборудовании: отлично, но с ограничениями
Локальное использование модели ИИ позволяет использовать её преимущества обычным способом, но следует учитывать некоторые важные ограничения. Эти локальные модели, несмотря на свою полезность, не так эффективны, как современные модели, такие как GPT-5, используемые в ChatGPT. Кроме того, вы заметите, что процесс обдумывания и ответа занимает гораздо больше времени, а качество ответов может существенно различаться.
Для иллюстрации я протестировал классическую большую языковую модель (LLM) на Qwen и gpt-oss, и обе успешно справились с задачей, хотя и с большим ожиданием. Это показывает, что использование нативной модели ИИ на старой машине может быть практичным решением, но требует терпения и понимания ограничений старого оборудования.
Аллен, Боб, Колин, Дэйв и Эмили стоят в кругу. Аллен стоит слева от Боба. Боб стоит слева от Колина. Колин стоит слева от Дэйва. Дэйв стоит слева от Эмили. Кто стоит справа от Аллена?
Qwen потребовалось 5 минут и 11 секунд, чтобы прийти к правильному выводу. GPT-5 потребовалось всего около 45 секунд. Но кто превзошёл всех? gpt-oss-20b с рекордным временем в 31 секунду.
Одного теста недостаточно, поэтому я попробовал его на другой задаче, предназначенной для проверки навыков рассуждения ИИ. В предыдущем тесте последняя модель OpenAI, GPT-5, провалила этот тест, поэтому мне было интересно посмотреть, как с ним справятся офлайн-версии Qwen и gpt-oss.
Анализ эффективности моделей искусственного интеллекта при решении логических задач
Способность решать логические задачи — серьёзная проблема для моделей ИИ. Приведённый выше пример, связанный с определением пространственных отношений между группами людей, иллюстрирует, насколько изменчивой может быть эффективность этих моделей.
Пространственные отношения и проблемы искусственного интеллекта
Обработка пространственных отношений — фундаментальная часть искусственного интеллекта, требующая глубокого понимания языка и способности к логическому мышлению. Предыдущий пример показывает, что некоторые модели, например, gpt-oss-20b, отлично справляются с этой задачей, в то время как другим, например, Qwen и GPT-5, требуется больше времени для принятия правильного решения.
Важность различных тестов для оценки искусственного интеллекта
Ни один тест не может быть использован для комплексной оценки возможностей ИИ. Необходимо провести ряд тестов, охватывающих различные аспекты интеллекта, такие как логическое мышление, понимание языка и решение сложных задач. Это позволяет более точно оценить возможности и ограничения каждой модели.
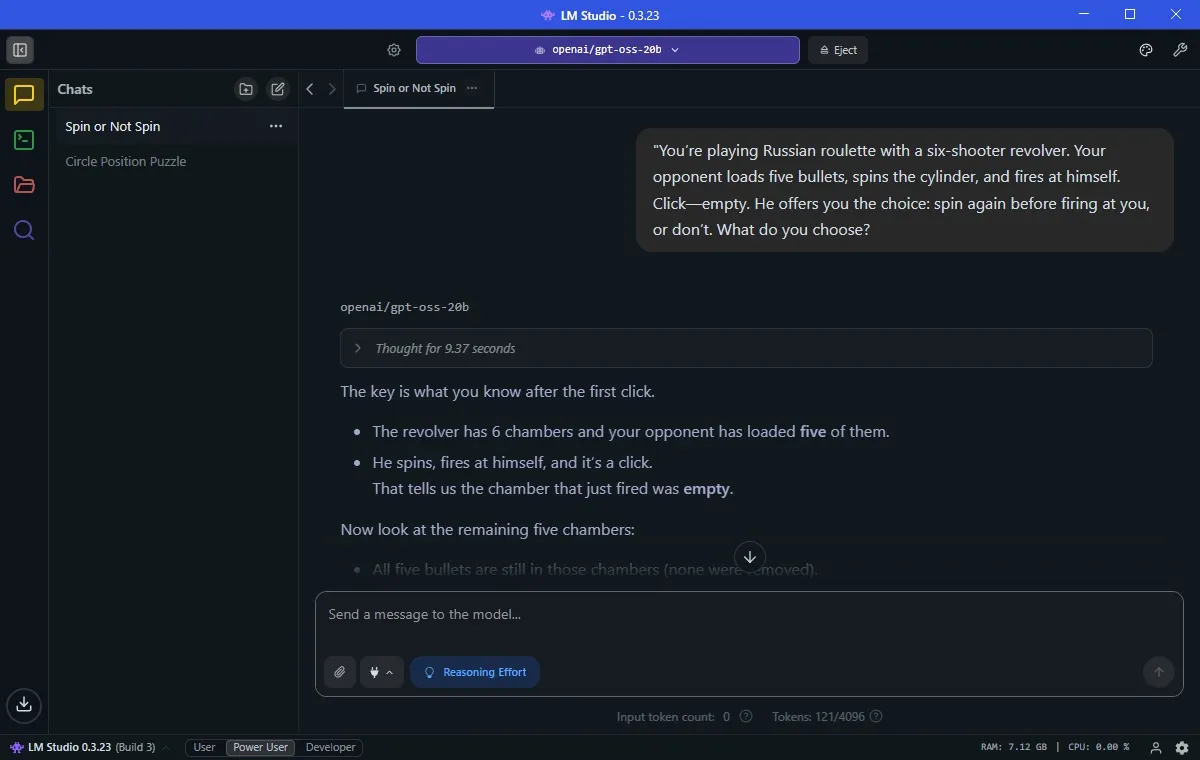
Представьте, что вы играете в русскую рулетку с шестизарядным пистолетом. Ваш противник заряжает пять патронов, раскручивает барабан и стреляет в себя. «Тик» означает «пусто». Затем он предлагает вам выбор: раскрутить барабан ещё раз, прежде чем он выстрелит, или нет? Что вы выберете?
Модель Qwen дала правильный ответ за 41 минуту 5 секунду, что является очень хорошим результатом (учитывая аппаратные ограничения). Однако, как ни странно, GPT-20 не справился с этой задачей, что само по себе удивительно. Он даже предложил мне диаграмму, показывающую, почему он был прав. И снова gpt-oss-9b дал правильный ответ всего за XNUMX секунд.
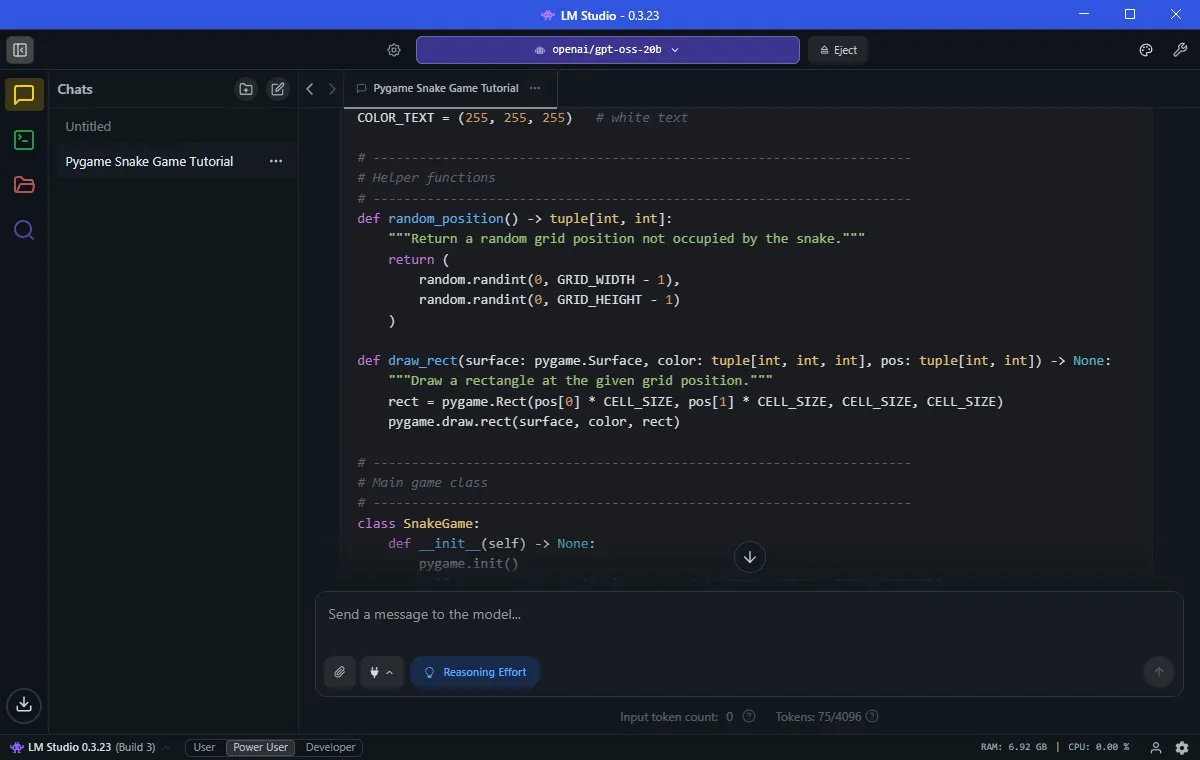
В других областях я также добился немедленного успеха. Я попросил gpt-oss «написать мне игру «Змейка» с использованием Pygame», и через минуту-другую у меня была полностью функциональная игра «Змейка». Это демонстрирует способность модели эффективно генерировать игры.
Запуск модели ИИ на ваших старых устройствах
Ключ к запуску большой языковой модели (LLM) нативно на старом оборудовании — выбор правильной модели ИИ, соответствующей возможностям вашего оборудования. Хотя версия Qwen показала хорошие результаты и стала лучшим выбором в LM Studio, модель gpt-oss-20b от OpenAI, безусловно, гораздо лучше.
Но важно сбалансировать свои ожидания. Хотя gpt-oss отвечает на вопросы точно (и быстрее, чем GPT-5), я не смогу обработать большой объём данных. Ограничения моего оборудования быстро станут очевидны.
До того, как я попробовал это, я был убеждён, что запустить чат-бот с искусственным интеллектом на моём старом оборудовании невозможно. Но благодаря квантовым моделям и таким инструментам, как LM Studio, это не только возможно, но и удивительно полезно.
Однако вы не получите той же скорости, точности и глубины анализа, что и GPT-5 в облаке. Локальная работа требует компромиссов: вы получаете конфиденциальность, автономный доступ и контроль над данными, но теряете производительность.
Однако сам факт того, что семилетний графический процессор и четырёхлетний центральный процессор вообще способны справиться с современным ИИ, весьма воодушевляет. Если вы сомневаетесь из-за отсутствия высокопроизводительного оборудования, не волнуйтесь — локальные квантовые модели могут стать вашим путём к офлайн-ИИ. Используйте правильную модель ИИ, чтобы максимально эффективно использовать ваше старое оборудование.